Un brief, seis configuraciones de Claude Code: una comparativa
Resumen
El 29 de septiembre de 2026 le di un mismo brief a seis formas de usar Claude Code: construir una página generativa e interactiva en JavaScript vanilla. La configuración A usó los prompts de agentes de Odoo Launchpad, el control plane de hosting para Odoo que construí con agentes de Claude; las demás fueron Claude Code sin extras, gstack, ECC, un workflow multiagente y un equipo de agentes. Cada ejecución tuvo su propio sandbox, Claude Code 2.1.284, Opus 5.5 y un tope de $25. El workflow corrió dos veces, en modo headless e interactivo, así que hubo siete ejecuciones, y las medí a partir de sus transcripciones y de un navegador headless. El workflow headless no construyó nada. Las otras seis páginas funcionaron sin errores y sin solicitudes externas, y cinco de ellas son simulaciones del moho mucilaginoso Physarum. Costaron entre $2.33 y $10.64. Cuando rompí código a propósito, las cuatro suites de pruebas detectaron un núcleo de simulación roto, y solo las de A y C detectaron la entrada del puntero rota, en ambos casos fuera del comando de pruebas por defecto.
La pregunta
Construí Odoo Launchpad, un control plane para alojar negocios en Odoo, entre julio y agosto de 2026, casi por completo con agentes de Claude. Tenía su propio pipeline de prompts de agentes: un spec drafter, un initializer y sesiones de coder que avanzaban por un checklist. La mayoría de sus specs se construyeron fuera de ese pipeline, en sesiones de Claude Code que yo conducía directamente. Quería saber cómo se comparaba el pipeline con otras formas de usar Claude Code en una tarea que nunca había visto. Así que le di un mismo brief a seis configuraciones, corrí cada una en un sandbox y medí lo que hizo y lo que entregó.
El modelo de desarrollo que derivé del registro de defectos de Launchpad cita estos resultados, y el ensayo de Launchpad describe ese modelo.
Método
Condiciones
Cada ejecución recibió el mismo brief y su propio repositorio git vacío. Todas usaron Claude Code 2.1.284 con Opus 5.5, el modo de permisos auto y un tope de $25, dentro de un aislamiento de sandbox-exec de macOS con un directorio home falso que bloqueaba las llaves SSH, las credenciales y las carpetas de las otras ejecuciones. Los gates de aprobación tenían aprobación permanente, y cada ejecución registró las preguntas que le habría hecho a una persona.
El brief, en inglés, fue este:
Build a cool generative, algorithmic, interactive page in vanilla JavaScript. No frameworks, no libraries, no build step. Make it something you would be proud to show.
En español: “Construye una página llamativa, generativa, algorítmica e interactiva en JavaScript vanilla. Sin frameworks, sin bibliotecas, sin paso de build. Haz algo que te enorgullezca mostrar.”
Las seis configuraciones
| Ejecución | Configuración | Cómo se ejecutó |
|---|---|---|
| A | Los prompts de Launchpad | los prompts reales agents/*.md de Launchpad, compuestos como los compone su pipeline: un spec drafter, un initializer y luego sesiones nuevas de coder hasta completar el checklist |
| B | Claude Code sin extras | el brief y nada más |
| C | Claude Code con gstack | instalado con su propio setup; /office-hours, /autoplan, build, /review, /qa, /ship |
| D | Claude Code con ECC | instalado desde su checkout fijado; el flujo orch-pipeline: agente planificador, desarrollo guiado por pruebas, agentes revisores |
| E | Workflow, headless | claude -p escribiendo y corriendo su propio workflow multiagente |
| E2 | Workflow, interactivo | la misma configuración en una sesión real de terminal controlada por expect |
| F | Equipo de agentes | un líder más compañeros de equipo de simulación, interfaz y pruebas, en modo interactivo porque los equipos no se forman con claude -p |
A es el pipeline de Launchpad, que el repositorio llama “el método de este repositorio”: los mismos prompts que guiaron a los agentes de Launchpad, con un repositorio vacío y el brief.
E y E2 son una misma configuración corrida de dos maneras. Cada ejecución escribió su propio workflow, así que los dos difieren: el de E tenía cinco fases (Ideate, Judge, Build, Review, Polish) y el de E2 tenía seis (Concept, Judge, Build, Review, Fix, Verify). El documento del repositorio las cuenta de la misma forma: seis configuraciones en siete ejecuciones.
Qué medí
Estas son las medidas. Salvo los break-checks, que corrieron la propia suite de pruebas de cada ejecución, provienen de las transcripciones o de un navegador headless.
- Costo en dólares estadounidenses. E2 y F corrieron en modo interactivo, así que sus costos son estimaciones a partir de las transcripciones, con tarifas por token ajustadas a los costos que reportaron las propias ejecuciones headless (con una diferencia de alrededor de 7%).
- Minutos de tiempo de reloj. Las ejecuciones compartieron una máquina al mismo tiempo, así que son aproximados.
- Conteos de proceso a partir de las transcripciones: llamadas a herramientas, lotes paralelos de llamadas a herramientas, capturas de pantalla que leyó el agente, commits y archivos de prueba.
- Break-checks de dos guardas en cada ejecución: el núcleo de la simulación y la entrada del puntero. Rompí la línea a propósito, y la propia suite de pruebas de la ejecución tenía que fallar. El
scripts/break-check.shde Launchpad hace esto: aplica un reemplazo literal que debe coincidir exactamente una vez, exige que la suite termine con un código distinto de cero y con al menos una líneanot ok, restaura el archivo desde una copia byte por byte y exige que la suite vuelva a pasar. El código de salida 0 significa que la guarda es real, 1 significa que romper la línea no hizo fallar la suite, y 2 significa un problema en el propio check. - Razón de movimiento reducido: el movimiento con
prefers-reduced-motiondividido entre el movimiento normal, después de estabilizarse. Una razón de 0 significa que la página deja de moverse, y una mayor que 1 significa que se mueve más que sin el ajuste. - Errores y solicitudes en un navegador headless: errores de consola, errores de página y solicitudes fuera del origen de la página.
Resultados
Qué se entregó
Seis de las siete ejecuciones entregaron una página. El workflow de E se detuvo cuando terminó su sesión headless: no construyó nada, salió con estado 0 y su repositorio solo contiene el commit vacío con el que se inicializó.
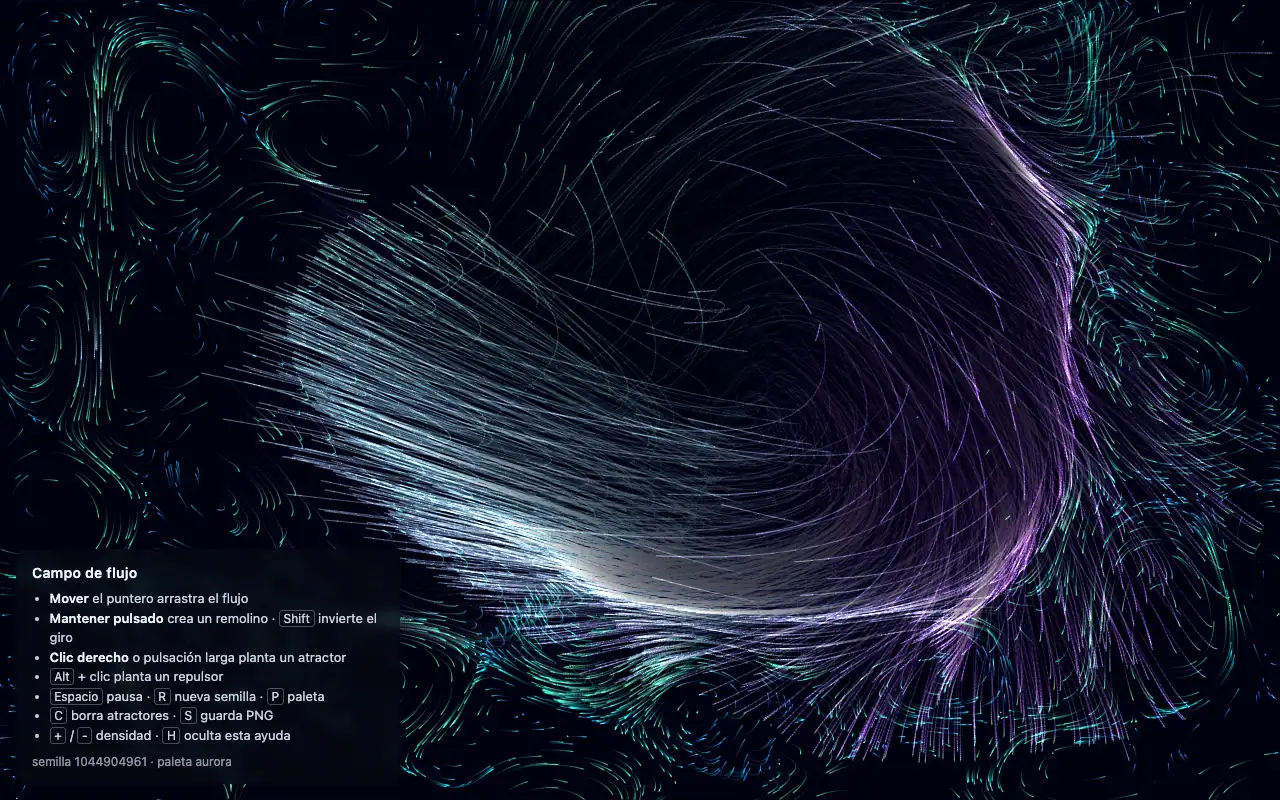
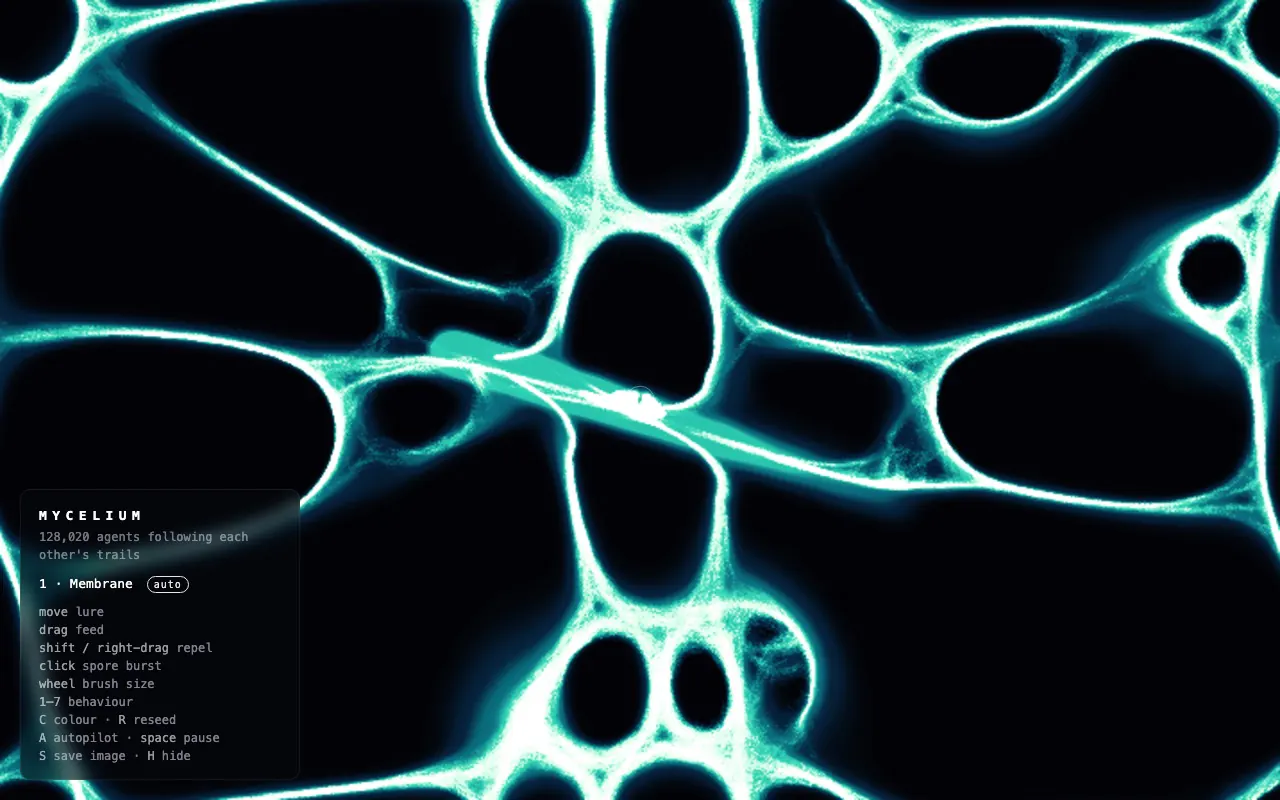
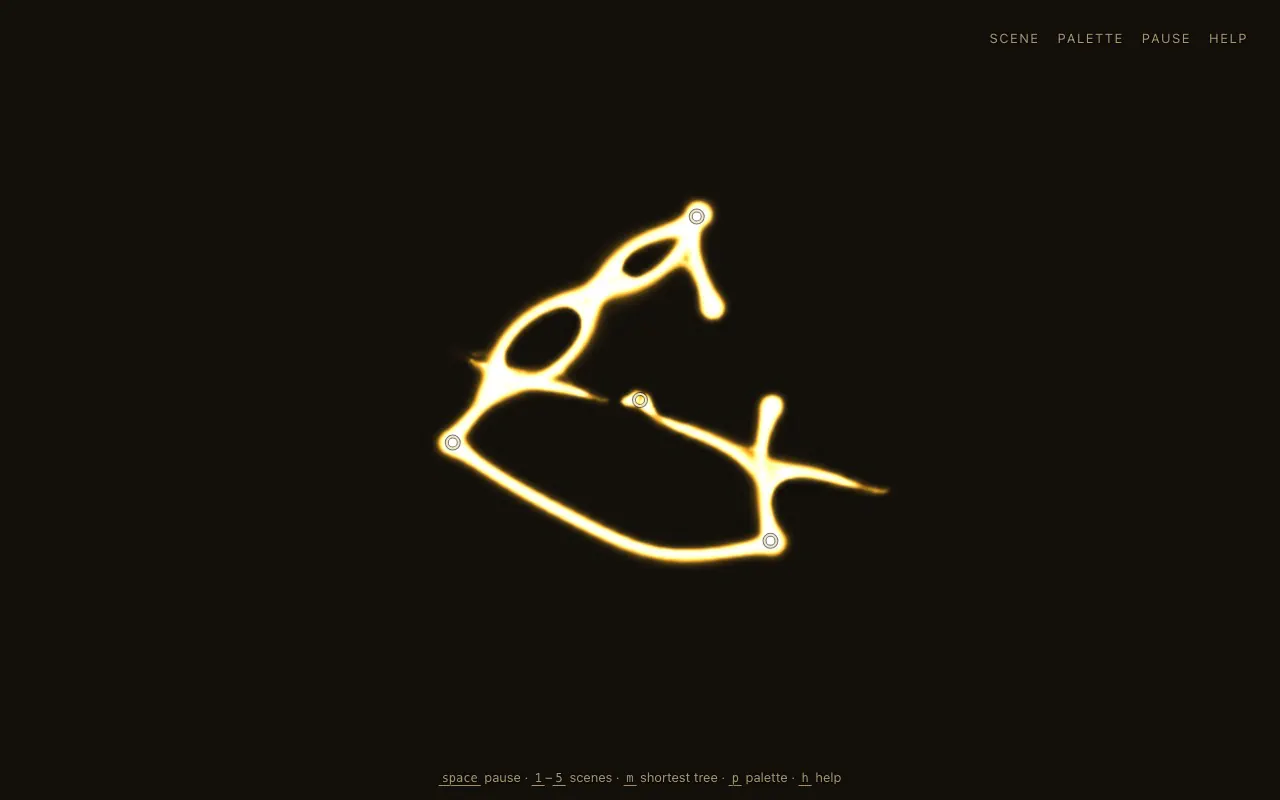
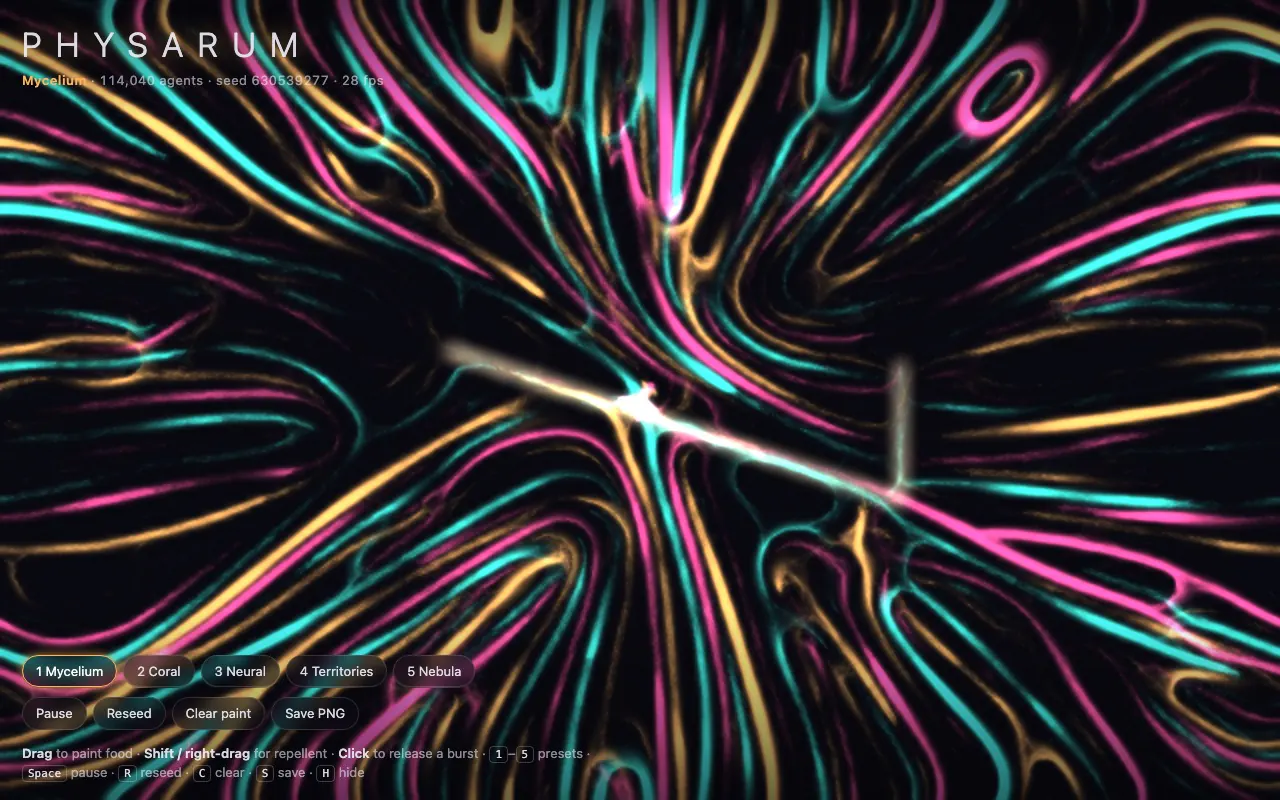
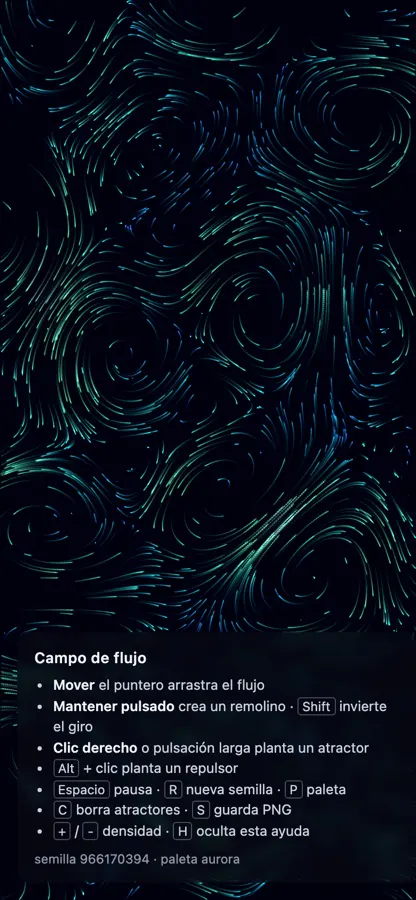
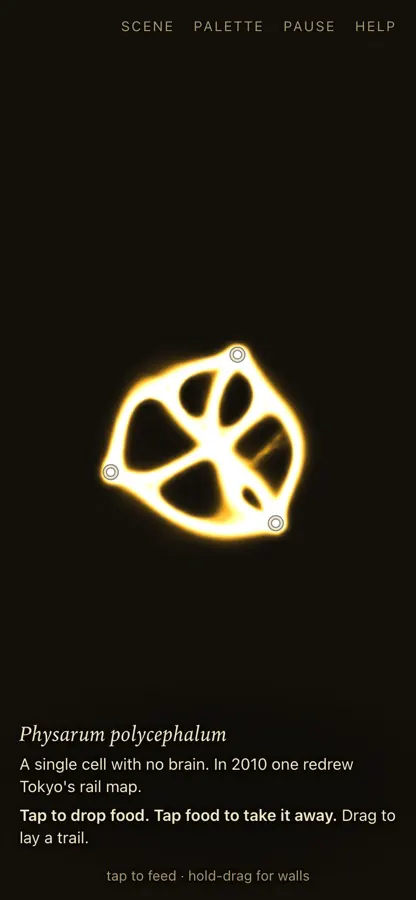
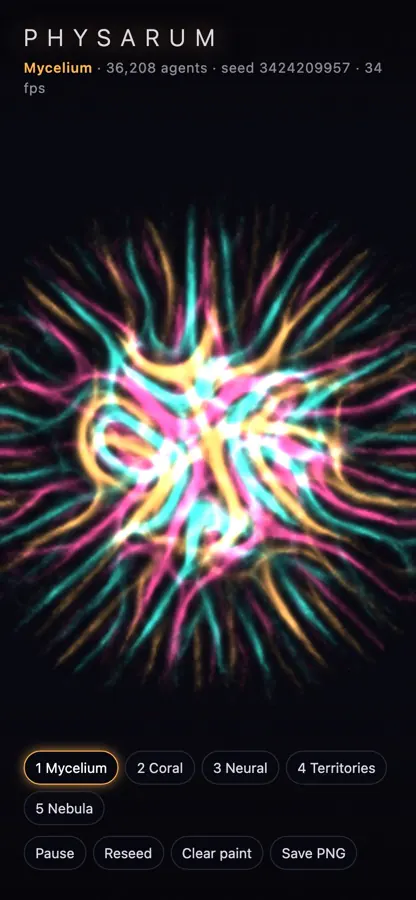
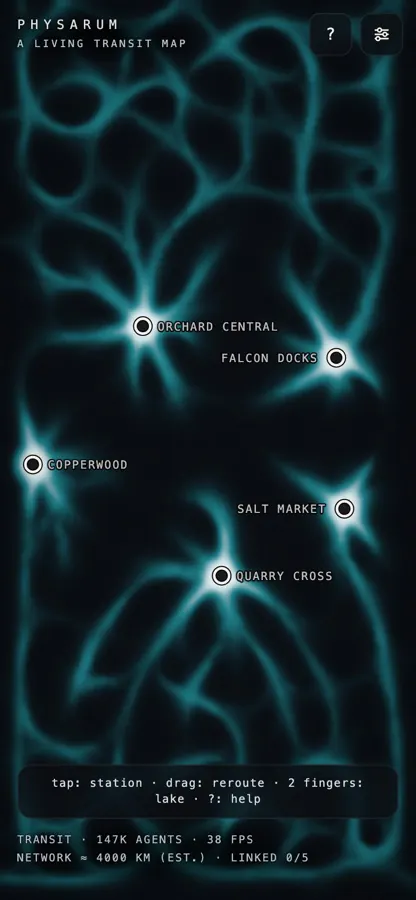
Cinco de las seis páginas son la misma idea, una simulación del moho mucilaginoso Physarum basada en el modelo de agentes de Jeff Jones de 2010. A, la ejecución que usó los prompts de Launchpad, construyó un campo de flujo: partículas que siguen un campo de curl noise variable en el tiempo, que el puntero deforma con remolinos, atractores y repulsores.
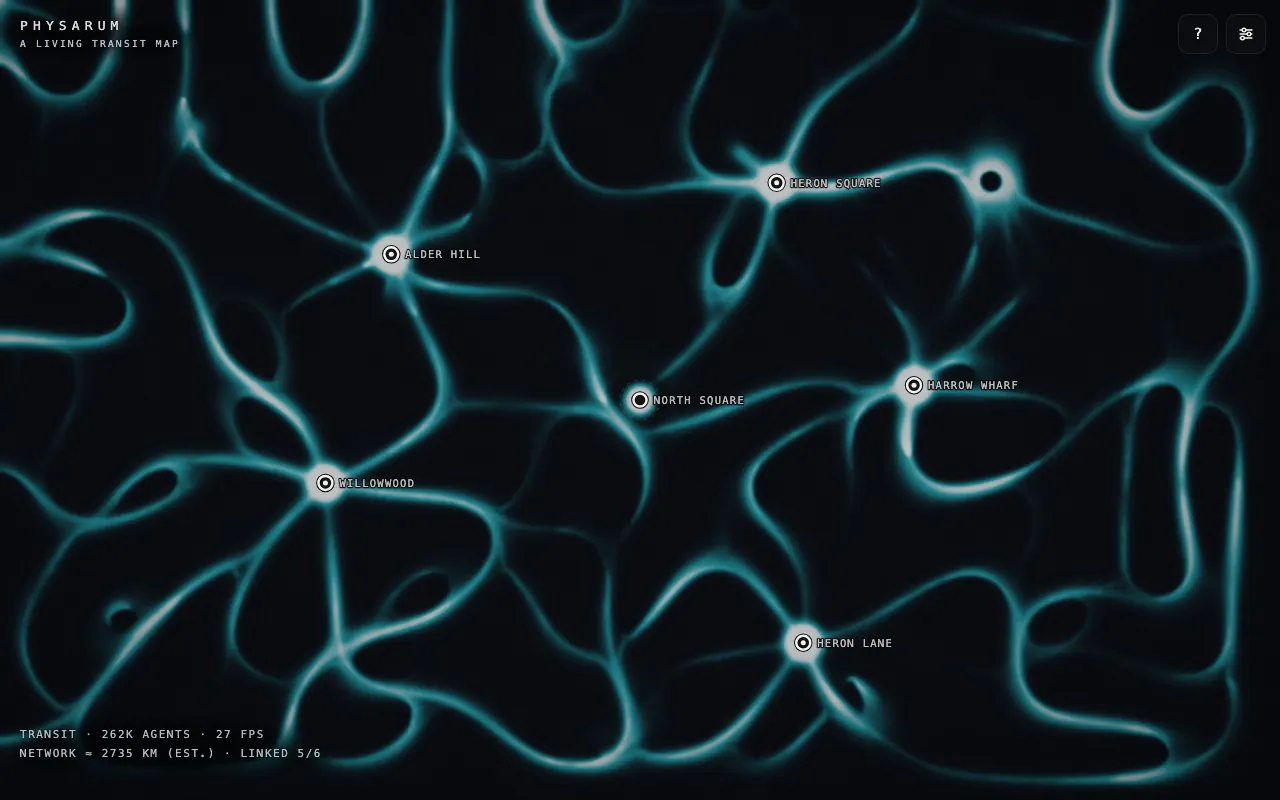
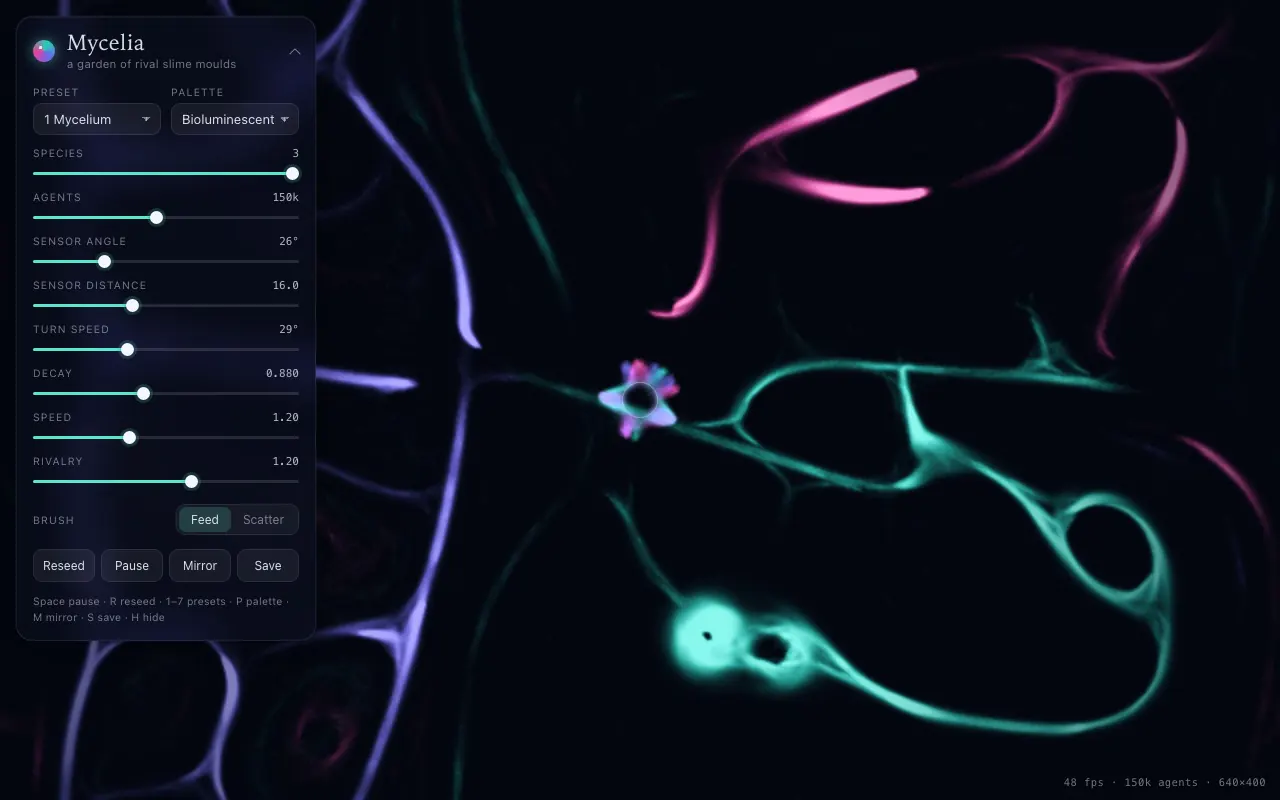
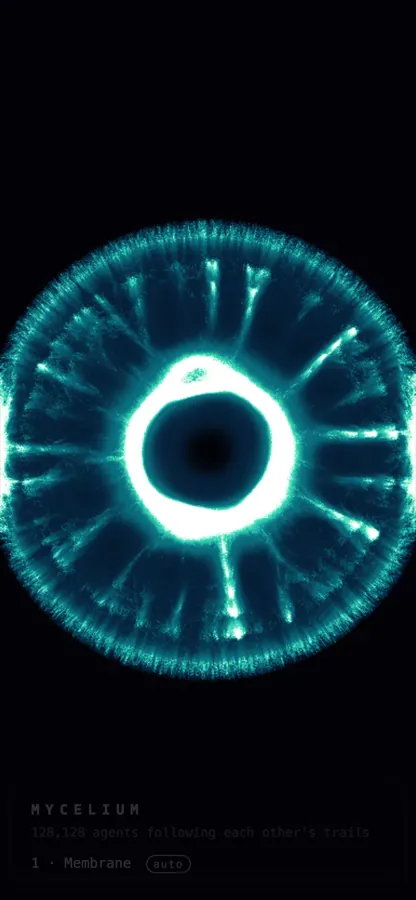
Lo que hace cada página, según el reporte de su propia ejecución (los conteos de agentes son cifras de las propias ejecuciones):
- A, Campo de flujo (el título original, en español): ruido simplex con semilla, cinco paletas y un panel de ayuda. La página, su spec y sus commits están en español.
- B, Mycelium: hasta unos 250k agentes, siete comportamientos en las teclas 1–7, seis paletas y un piloto automático que arranca tras 12 segundos sin entrada.
- C, Physarum: a slime mold you can feed: más de 100,000 agentes y cinco escenas. Su escena Tokyo 2010 coloca comida en 22 coordenadas reales de estaciones del Gran Tokio, siguiendo a Tero et al. (2010), y la tecla
msuperpone el árbol de expansión mínima entre los puntos de comida. - D, Physarum: three species of living light: unos 100k agentes en tres especies que se orientan hacia su propia estela y se alejan de las de las otras, con cinco presets.
- E2, Physarum Transit: WebGL2 con hasta alrededor de 1M de agentes y un respaldo en Canvas2D. Colocas y arrastras estaciones, y la red se vuelve a trazar entre ellas.
- F, Mycelia: hasta unos 150k agentes de una a tres especies, siete presets y un panel de sliders para cada parámetro.
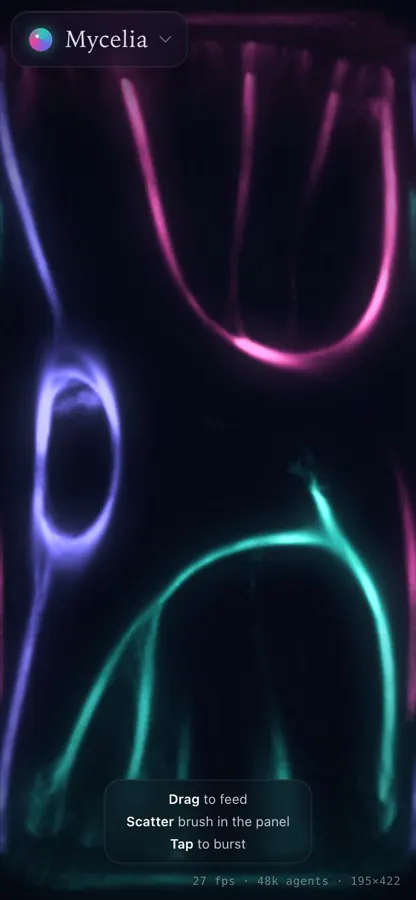
Costo y tiempo
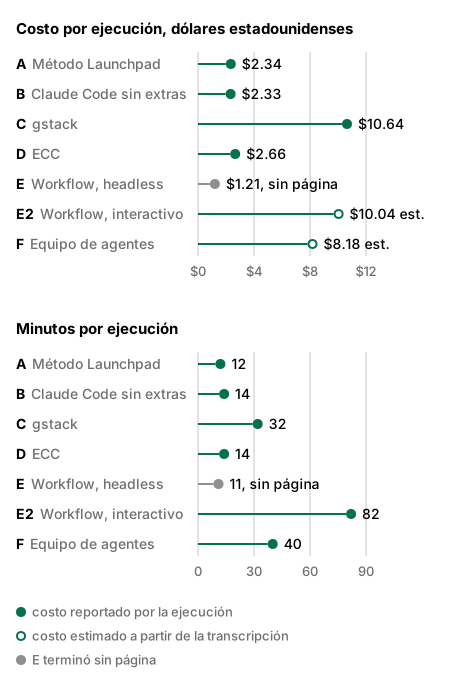
A, B y D costaron $2.34, $2.33 y $2.66. C, E2 y F costaron $10.64, $10.04 y $8.18, así que la página más cara costó más de cuatro veces lo que costó la más barata. Las tres ejecuciones más baratas también fueron las tres más cortas: de 12 a 14 minutos para A, B y D, contra 32 a 82 para C, F y E2. Como las seis páginas funcionaron, el gasto extra pagó revisión y pulido. E gastó $1.21 en 11 minutos y no entregó nada.
Cómo trabajaron las ejecuciones
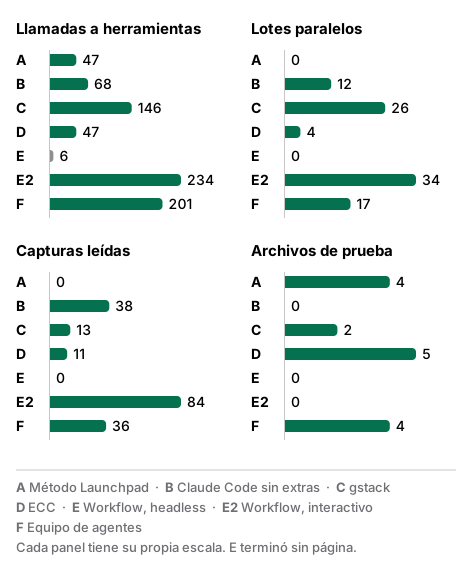
Las llamadas a herramientas iban de 6 en E a 234 en E2. La división más interesante es entre mirar y probar. B y E2 ajustaron sus páginas de forma visual: leyeron 38 y 84 capturas de pantalla y no conservaron archivos de prueba. A escribió 4 archivos de prueba y no leyó ninguna captura. En su tercera sesión de coder, A no pudo iniciar Chrome dentro del sandbox, así que verificó el comportamiento de la página con un DOM simulado en Node; en su cuarta sesión Chromium sí arrancó y A escribió una suite smoke con Playwright, pero aun así nunca leyó una captura de su página.
A tampoco hizo lotes paralelos de llamadas a herramientas. Los prompts de coder, initializer y fixer de Launchpad afirman que el runtime emite exactamente una llamada a herramienta por turno, una cifra medida en 414 de 414 turnos durante las propias ejecuciones de Launchpad, y A siguió esa línea. La documentación de Launchpad corrigió después la lectura detrás de esa afirmación: el uso paralelo de herramientas está activado por defecto, y una traza de dos sesiones de Launchpad encontró que 22 de sus 24 llamadas a herramientas fueron llamadas con estado a Bash, Edit o Write que dependían de la llamada anterior, así que el trabajo tenía poco que agrupar. Los prompts todavía incluyen la frase anterior, y la comparativa los corrió sin cambios. B, sin ningún prompt, hizo 12 lotes.
Qué protegían las pruebas
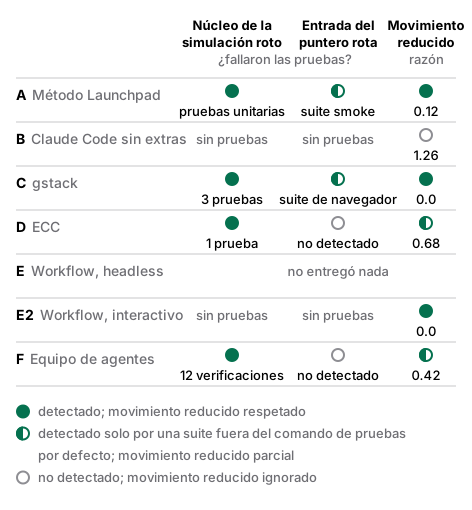
Las cuatro ejecuciones con suite de pruebas detectaron un núcleo de simulación roto. Fallaron las pruebas unitarias de A, al igual que 3 pruebas en C, 1 prueba en D y 12 verificaciones en F. B y E2 no conservaron pruebas, así que el break-check no tenía nada que correr.
Las suites difirieron con la entrada del puntero rota. Las suites de D y F siguieron en verde. Las de A y C fallaron, y en ambos casos las verificaciones que fallaron estaban fuera del comando de pruebas por defecto:
- La verificación de A está en una suite smoke de Playwright que corre con
npm run test:smoke. Elnpm testde A y su comando de CI la omitían. - La de C son 4 verificaciones de una suite de navegador de 48 verificaciones que corre con
npm run qay necesita una rutaPLAYWRIGHT=y un servidor en el puerto 8765, y el repositorio no declara ninguna de las dos cosas. Elnpm testde C corre 24 pruebas de node.
Así que en ninguno de los seis repositorios el comando de pruebas por defecto, donde existe, fallaría con la entrada del puntero desconectada. El documento del repositorio también registra una prueba llamada “drag changes the trail” que siguió pasando con el arrastre desconectado.
Movimiento reducido
A, C y E2 respetaron el movimiento reducido, con razones de 0.12, 0.0 y 0.0; E2 llegó a 0.0 después de un calentamiento. D bajó a 0.68 y lo dijo, ya que su reporte indica que prefers-reduced-motion reduce a la mitad la tasa de la simulación. F bajó a 0.42, aunque su reporte dice que “se respeta el movimiento reducido”. B se movió más con el ajuste que sin él, con 1.26. Su código no maneja prefers-reduced-motion, y su reporte no afirma que lo haga.
Qué encontró la revisión
Las configuraciones con un revisor en un contexto nuevo encontraron bugs que sus builders habían pasado por alto:
- El subagente de
/reviewde C encontró 15 problemas, y C corrigió 14. Según el reporte de C, los peores eran que los usuarios de pantalla táctil con movimiento reducido se quedaban con una página en pausa y que los usuarios de pantalla táctil no podían cambiar de escena en absoluto. - Los agentes
code-reviewerytypescript-reviewerde D no reportaron problemas de severidad crítica ni alta, y D corrigió todos los hallazgos de severidad media y la mayoría de los de severidad baja. Entre las correcciones estuvieron el mapeo del puntero relativo al canvas y un redimensionamiento que ahora rehace la cuadrícula de la simulación en curso sobre la marcha; antes de la corrección, un redimensionamiento reiniciaba la simulación. - Los tres revisores en paralelo de E2 reportaron 10 hallazgos confirmados (4 de severidad media, 6 de severidad baja), entre ellos un nombre de estación vulgar que su generador de nombres podía producir.
- El compañero de equipo de pruebas de F reportó 3 bugs, uno de ellos que en pantallas táctiles no había forma de repeler.
A no tuvo paso de revisión.
Qué dijo sobre los prompts de Launchpad
El documento del repositorio llama a A “la ejecución más barata con auditoría completa”: costó $2.34, y B, con $2.33, no conservó pruebas. El spec de A citó evidencia para cada punto del checklist junto con el commit que lo resolvió, y A dejó su último punto abierto para una persona: una revisión visual y de rendimiento, con una meta de al menos 50 FPS a la densidad por defecto en una laptop común. Marcó lo que no había verificado y no afirmó nada más allá de eso.
La misma ejecución expuso cuatro problemas en los prompts:
- La línea sobre una llamada a herramienta por turno mantuvo a A en 0 lotes paralelos, contra 12 de Claude Code sin extras. En el trabajo secuencial del propio Launchpad, la misma línea costó poco, como registra
docs/AGENT-TOPOLOGY.md. - Los prompts llevaron detalles propios de Launchpad a un proyecto completamente nuevo. El spec de A tiene
tenant: launchpaden su frontmatter, y el spec, cuatro de sus cinco mensajes de commit y la página están en español, aunque el brief estaba en inglés. Los prompts de spec drafter, initializer y fixer de Launchpad exigen prosa en español. - No había paso de revisión, así que nada en la ejecución de A verificó lo que afirmaba el builder.
- El comando de CI de A omitía la suite de navegador, que era la única suite que detectó la entrada del puntero rota.
Estos resultados se citan en el modelo Proof of Work que derivé del registro de defectos de Launchpad. Ahí, el gate de pruebas es la unión de todos los tipos de prueba (de compilación, unitarias, de navegador y de journey), un revisor en un contexto nuevo verifica lo que afirma el autor en cada hito, y se eliminan las líneas de los prompts que describen el runtime del agente. El ensayo de Launchpad cubre ese modelo.
Discusión
Con un mismo modelo bajo todas las configuraciones, todas las páginas que se entregaron funcionaron, y cinco de las seis eligieron la misma idea. La configuración cambió cuánto costó una ejecución, cómo trabajó y qué cubrieron sus pruebas. Mi lectura es que el modelo fijó el techo de calidad, y que el gasto extra de C, E2 y F compró revisión y pulido en páginas que ya funcionaban.
Los resultados de las pruebas son el hallazgo sobre el que actuaría primero. Todas las suites protegían el algoritmo, que es la parte a la que las pruebas unitarias llegan con facilidad. La entrada del puntero necesita un navegador, y en las dos ejecuciones que la probaron, las verificaciones de navegador estaban fuera del comando que un desarrollador corre por defecto. Los break-checks son la única medida aquí que mostró esto.
Mirar y probar también se comportaron como habilidades separadas. Las ejecuciones que leyeron decenas de capturas no conservaron pruebas, y A, que escribió 4 archivos de prueba, nunca miró su página. La revisión en un contexto nuevo encontró bugs que los builders habían pasado por alto, como la página en pausa para usuarios de pantalla táctil en C y el redimensionamiento que reiniciaba la simulación en D.
Las ejecuciones headless mostraron dos límites de claude -p: un workflow que lanza se detiene cuando termina la sesión (por eso E no construyó nada y aun así salió con 0), y los equipos de agentes no se forman con él en absoluto. El documento también afirma que el modo auto vuelve en silencio a los permisos por defecto en Haiku; ninguna ejecución de esta comparativa usó Haiku, así que esa observación viene de fuera de estas siete ejecuciones.
Limitaciones
- Cada configuración corrió una sola vez, con un solo brief, en un solo día. Una diferencia entre dos configuraciones puede ser varianza entre ejecuciones.
- Los minutos son aproximados, y los costos de E2 y F son estimaciones.
- El documento cuenta como archivos de prueba los archivos incluidos en commits dentro de un directorio
test/,tests/o__tests__/, o con nombre*.test.*o*.spec.*. B y E2 entregaron scripts smoke de navegador fuera de ese patrón (tools/check.mjsytools/verify.mjs) que necesitan instalar por separado un driver de navegador, así que los conteos no los tratan como archivos de prueba. La regla cuenta archivos por ruta: los 4 de A incluyen sus dos pruebas smoke, que sunpm testno corre, y los 4 de F incluyen sutests/package.jsony su lock file. El documento no define cómo se contaron los lotes paralelos. - Yo escribí el brief, elegí las medidas y medí cada ejecución, y A es mi propio método.
- Las transcripciones, los reportes de las ejecuciones y los datos de medición no son públicos. El documento en el repositorio de Launchpad y las seis páginas alojadas aquí sí lo son.
Cómo reproducirlo
El sandbox, las transcripciones y los scripts que midieron las siete ejecuciones no están en un repositorio público, así que el experimento en sí no se puede volver a correr desde un clon. Dos partes sí se pueden.
Las páginas
Cada página se abre en su enlace en vivo de arriba. Cinco de las páginas cargan sus scripts como módulos ES por ruta relativa, así que una copia local necesita un servidor estático como python3 -m http.server. B carga un script clásico, así que es la única página que se puede abrir directamente desde el disco.
Re-ejecución del 16 de octubre de 2026: las seis copias en vivo se sirvieron con el http.server de Python y cada una se cargó en Chrome headless, controlado por puppeteer-core, a 1280×800 y a 390×844 con entrada táctil. Después de una espera de 4 segundos, se contaron los cuadros de animación durante 2 segundos. Las 12 cargas tuvieron 0 errores de consola, 0 advertencias, 0 errores de página, 0 solicitudes fallidas, 0 respuestas con estado 400 o mayor y 0 solicitudes a otro origen, y animaron a 52–60.5 cuadros por segundo. Esa tasa es la de cuadros de animación del navegador en la máquina que corrió la prueba y no dice nada sobre la velocidad de cada simulación.
Un break-check
scripts/break-check.sh del repositorio de Launchpad necesita bash y python3, y funciona en cualquier proyecto cuyo comando de pruebas imprima TAP. Este ejemplo tiene una línea protegida y una línea sin proteger:
git clone https://github.com/JCastrejonE/launchpad.git
mkdir demo && cd demo
printf 'export const add = (a, b) => a + b;\nexport const scale = (a, k) => a * k;\n' > sum.js
cat > sum.test.mjs <<'EOF'
import test from 'node:test';
import assert from 'node:assert/strict';
import { add } from './sum.js';
test('add', () => assert.equal(add(2, 3), 5));
EOF
bash ../launchpad/scripts/break-check.sh --file sum.js --from 'a + b' --to 'a - b' \
  --cmd 'node --test --test-reporter=tap'
bash ../launchpad/scripts/break-check.sh --file sum.js --from 'a * k' --to 'a / k' \
  --cmd 'node --test --test-reporter=tap'
En la re-ejecución del 16 de octubre de 2026 (macOS, Node 24.21.0), el primer comando salió con 0 y GUARD IS REAL: 1 failing test(s) when sum.js was mutated. y el segundo salió con 1 y NOT GUARDED: nothing failed when sum.js was mutated. El script cuenta las líneas que empiezan con not ok, así que el flag --test-reporter=tap fue necesario en Node 24.21.0; sin él, el script sale con 2 y reporta que la suite no corrió.
Referencias
- Juan Carlos Castrejón Estrada. “Setup bake-off.”
docs/SETUP-BAKEOFF.md, líneas 1–46, en el repositorio launchpad. - “Proof of Work.”
docs/PROOF-OF-WORK.md, líneas 100, 112 y 124, mismo repositorio. README.md, líneas 5, 67–68 y 74, mismo repositorio.scripts/break-check.sh, líneas 1–33 (uso y códigos de salida), mismo repositorio.agents/coder.mdlínea 75,agents/initializer.mdlínea 39 yagents/fixer.mdlínea 25 (la línea de una llamada a herramienta por turno);agents/spec-drafter.mdlínea 81,agents/initializer.mdlínea 98 yagents/fixer.mdlínea 59 (la regla de prosa en español), mismo repositorio.docs/AGENT-TOPOLOGY.md, líneas 193–235 (“Batching: available, on by default, and nothing to spend it on”), ydocs/AGENT-PERFORMANCE.md, línea 44 (los 414 turnos), mismo repositorio.- Registros de ejecución de la comparativa, no publicados: el spec de A (
plan.md, líneas 6, 142 y 146–150) y su lista de commits; los reportes de B, C, D, E2 y F; el registro de preguntas de D, punto 4; los archivos de workflow de E (líneas 4–10) y E2 (líneas 4–11); y las listas de commits de las siete ejecuciones. - Datos de medición de la comparativa, no publicados: costo, minutos, conteos de proceso, resultados de las guardas y razón de movimiento reducido de cada ejecución.
- Re-ejecuciones del 16 de octubre de 2026, descritas en “Cómo reproducirlo”: la prueba de las páginas en vivo y el ejemplo de break-check.
- J. Jones. “Characteristics of pattern formation and evolution in approximations of Physarum transport networks.” Artificial Life 16(2), 2010. Citado por los reportes de B, D, E2 y F.
- A. Tero et al. Science 327(5964), 2010: el experimento con Physarum que reprodujo la red ferroviaria del Gran Tokio. Citado por el reporte de C para su escena de Tokio.