Simulación de la evolución de dominios proteicos con un autómata celular
Resumen
En junio de 2023 terminé un proyecto de implementación para el Seminario de Genómica Computacional de la Facultad de Ciencias de la UNAM. El proyecto preguntaba cómo puede un autómata celular simular la evolución de dominios proteicos, y seguía el método de Xiao, Xue, Stamatovic y Qiu (2020): una retícula unidimensional en la que una celda vacía junto a una llena extrae su estado por selección de ruleta a partir de dos matrices de adyacencia, F2B y B2F. Como prueba de concepto deliberada, mi notebook estima ambas matrices a partir de los 3890 pares adyacentes del gen bont de Clostridium botulinum, de 3891 nucleótidos, así que sus estados son las bases A, C, G y T. Ejecuta una retícula de 17 celdas durante 8 actualizaciones a partir de una A ancestral. La re-ejecución de octubre de 2026 reproduce con exactitud los 32 valores impresos de las matrices. El notebook actualiza la retícula in situ, así que en las 10000 re-ejecuciones con semilla la primera actualización llenó las celdas 9 a 15. El proyecto no tiene ninguna evaluación contra arquitecturas de dominios reales.
La pregunta
Este fue mi proyecto de implementación para el Seminario de Genómica Computacional de la Facultad de Ciencias de la UNAM. Las diapositivas finales, presentadas en 2023, llevan el título Autómatas Celulares en la Simulación de la Dinámica de Dominios Proteicos. El repositorio contiene las diapositivas (18 páginas), un notebook de Jupyter con tres celdas de código ejecutadas y un archivo de entrada en formato FASTA.
Las diapositivas plantean una sola pregunta de investigación: ¿cómo se pueden utilizar los autómatas celulares para simular la evolución de dominios de proteínas? De ella se sigue el objetivo: desarrollar un modelo basado en autómatas celulares que simule esa evolución. La motivación que dan es que la evolución de dominios puede proporcionar información sobre la historia de la vida y la función de los organismos actuales, y que podría ayudar a prever cómo progresan las enfermedades o cómo evolucionan los patógenos.
La versión de avance de las diapositivas, que subí al repositorio en abril de 2023, tenía un segundo objetivo: analizar y validar el modelo propuesto con datos experimentales. La versión final de junio conserva solo el primero.
El método que seguí
Las diapositivas siguen a Xiao, Xue, Stamatovic y Qiu (2020), quienes simulan la evolución de dominios con un autómata celular probabilístico unidimensional [1]. Según la definición de las diapositivas, cada celda está en uno de g + 3 estados: g clases de dominio, dos símbolos de terminación y el estado vacío ∅. Al inicio, la celda central contiene un dominio ancestral y todas las demás están vacías. El autómata evoluciona durante tantos pasos de tiempo como dominios tiene la proteína con más dominios en los datos de entrenamiento.
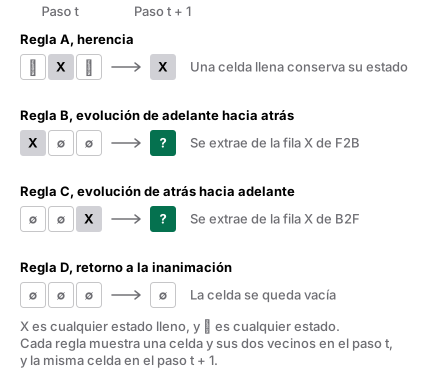
Cuatro reglas deciden el siguiente estado de una celda a partir de la celda y sus dos vecinos:
- Regla A, herencia. Una celda llena conserva su estado.
- Regla B, evolución de adelante hacia atrás. Una celda vacía cuyo vecino izquierdo está lleno y cuyo vecino derecho está vacío toma un estado extraído por selección de ruleta de la fila de F2B que corresponde a su vecino izquierdo.
- Regla C, evolución de atrás hacia adelante. El caso simétrico: una celda vacía con el vecino izquierdo vacío y el vecino derecho lleno extrae su estado de la fila de B2F que corresponde a su vecino derecho.
- Regla D, retorno a la inanimación. Una celda vacía con sus dos vecinos vacíos se queda vacía.
F2B[x][y] es la probabilidad de que el estado y siga al estado x, y B2F[x][y] es la probabilidad de que y preceda a x. Ambas matrices salen de contar pares adyacentes en los datos de entrenamiento.
Las diapositivas también presentan la matriz de sustitución de aminoácidos de Margaret Dayhoff como un modelo que el proyecto usaría [3]. El notebook no la usa.
Lo que implementa el notebook
La entrada es ADN
El notebook lee la línea 2 de src/protein.fasta en una variable llamada secuencia_proteina. El archivo contiene una secuencia de nucleótidos. Usarla fue una decisión de diseño deliberada: el notebook es una prueba de concepto del método sobre una secuencia de nucleótidos, con las cuatro bases en el papel de clases de dominio. Su encabezado es:
>NC_009495.1:909709-913599 bont [organism=Clostridium botulinum A str. ATCC 3502] [GeneID=5185061] [chromosome=]
La re-ejecución de octubre de 2026 contó 3891 caracteres, todos A, C, G o T: A 1579, C 394, G 629 y T 1289. Esa longitud es 913599 − 909709 + 1. Traducida con Biopython 1.85 (tabla 11 del código genético), la secuencia da 1297 codones con un solo codón de paro al final, y la proteína empieza con MPFVNKQFNYKDPVNGVDIAYIKIPNAGQMQPV. Así que el archivo es la secuencia codificante del gen bont (neurotoxina botulínica). El notebook nunca la traduce, y los cuatro estados que evoluciona el autómata son las bases A, C, G y T.
Las matrices
La primera celda cuenta cada par adyacente (s[i], s[i+1]) de la secuencia, 3890 pares en total, y divide cada fila de conteos entre su total. El resultado es F2B[x][y] = P(la siguiente base es y | la base actual es x) y B2F[x][y] = P(la base anterior es y | la base actual es x).
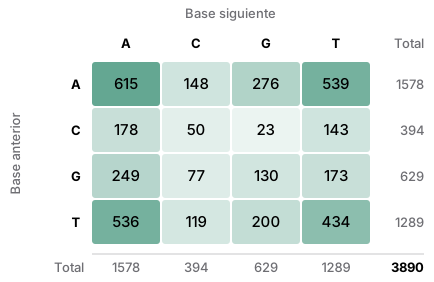
Por ejemplo, el notebook imprime F2B AA como 0.3897338403041825, que es 615/1578, y B2F “CA” (C antes de A) como 0.11280101394169835, que es 178/1578.
El autómata
La segunda celda define la clase AutomataCelular(m, g, dominio_ancestral, F2B, B2F). Esta construye una retícula de 2m + 1 celdas con valor '∅' y coloca el estado ancestral en la celda m. La selección de ruleta obtiene un valor con np.random.uniform(0, sum(p)) y devuelve el primer estado cuya probabilidad acumulada supera ese valor. El notebook no fija ninguna semilla aleatoria.
El ciclo de actualización recorre las celdas 1 a 2m − 1, así que nunca actualiza la primera ni la última celda, y aplica las reglas A a D en ese orden. Escribe cada nuevo estado en el mismo arreglo que lee. La tercera celda ejecuta el autómata con m=8, g=4 y estado ancestral 'A': una retícula de 17 celdas, 8 actualizaciones y 9 filas impresas.
El código difiere de las diapositivas en cinco puntos:
Diapositivas (main.tex) |
Notebook (CA.ipynb) |
|
|---|---|---|
| Estados | g + 3: clases de dominio, dos símbolos de terminación y ∅ | 5: A, C, G, T y ∅ |
| g | número de clases de dominio | se pasa como 4 y nunca se lee |
| Número de pasos | dominios en la proteína con más dominios en los datos de entrenamiento | m = 8, una constante |
| Actualización | cada regla se aplica “en el próximo paso de tiempo” | in situ, de izquierda a derecha |
| Celdas de frontera | no se especifica | las celdas 0 y 16 nunca cambian |
Lo que midió la re-ejecución
Todo lo de esta sección viene de la re-ejecución de octubre de 2026, con Python 3.9.6 y numpy 2.0.2. El notebook registra Python 3.8.4.
- El notebook se ejecutó sin cambios con nbconvert, y su salida se comparó con la salida guardada en el repositorio.
- La clase se copió a un script que registra cada paso, y se ejecutó con las semillas 0 a 9 de numpy dos veces: una con la actualización in situ del notebook y otra con una variante síncrona en la que cada celda lee el paso anterior, que es lo que describen las diapositivas.
- La versión in situ se ejecutó 10000 veces a partir de la semilla 12345, y se contaron las celdas llenas después de la primera actualización y al final, junto con las frecuencias de pares de bases en el lado derecho de la retícula.
- Se calculó la probabilidad de la fila final guardada en el repositorio bajo el propio modelo del notebook.
Resultados
La ejecución del notebook
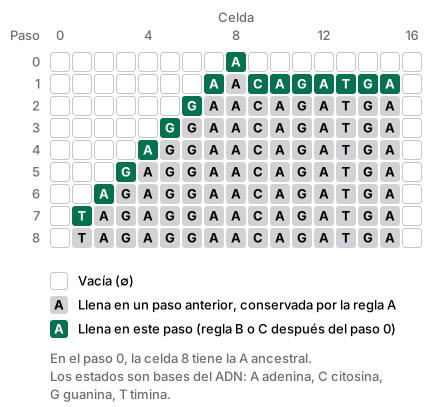
Después de la primera actualización, las celdas 7 a 15 están llenas. La regla C llena la celda 7, y la regla B llena las celdas 9 a 15 en un solo recorrido, porque cuando el ciclo llega a la celda 10, la celda 9 ya tiene la base que se extrajo para ella un momento antes. Después, el lado izquierdo gana una celda por actualización y llega a la celda 1 en el paso 7. La última actualización no cambia nada, porque la celda 0 nunca se actualiza. La fila final es ∅TAGAGGAACAGATGA∅.
La diapositiva de resultados es cualitativa. Dice que “se ha mostrado una implementación novedosa para representar la evolución de los dominios proteicos, tomando como ventaja la naturaleza compleja de los autómatas celulares para reflejar con simplicidad un fenómeno difícil de estudiar que se puede aprovechar en múltiples áreas científicas”. No reporta ninguna métrica, ninguna comparación con arquitecturas de dominios reales ni ejecuciones repetidas.
La re-ejecución
| Verificación (re-ejecución) | Resultado |
|---|---|
| Los 16 valores de F2B y los 16 de B2F que imprime la primera celda | idénticos byte por byte a la salida guardada en el repositorio |
| Forma de la ejecución del autómata sin semilla | bases distintas, misma forma que la ejecución guardada |
| La primera actualización llena las 7 celdas de la 9 a la 15 (10000 ejecuciones in situ) | 10000 de 10000 |
| Celdas llenas en la retícula final (10000 ejecuciones in situ) | 15 en todas las ejecuciones |
| Frecuencia de A después de A en el lado derecho, contra F2B AA | 0.39031983318159125 contra 0.3897338403041825 |
| Probabilidad de la fila final guardada bajo el modelo | 8.073410076915032e-09 |
El último valor es el producto de 14 factores: 7 valores de F2B para las celdas 9 a 15 y 7 valores de B2F para las celdas 7 a 1. La fila guardada es una muestra entre muchas.
Discusión
La re-ejecución confirma dos partes del notebook. Las matrices coinciden hasta el último dígito, y los pares de bases que extrae la ruleta en el lado derecho siguen a F2B, por ejemplo A después de A con frecuencia 0.39031983318159125 contra 0.3897338403041825.
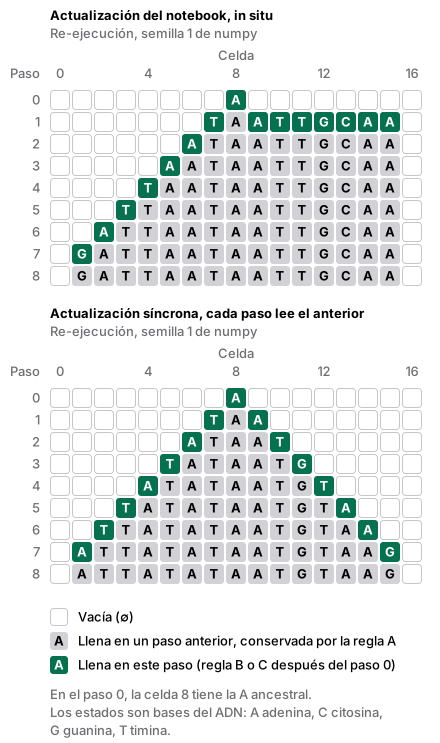
La actualización in situ cambia el orden en que se llenan las celdas, y deja igual la distribución de la fila final. Según el código, con cualquiera de los dos órdenes de actualización cada celda a la derecha del centro se extrae de la fila de F2B de su vecino izquierdo, y cada celda a la izquierda del centro, de la fila de B2F de su vecino derecho. Así, toda fila final consiste en dos cadenas de 7 bases extraídas hacia afuera desde la A ancestral, con la estadística de pares adyacentes del gen bont. Los dos órdenes difieren en el diagrama espacio-tiempo, que es el camino que sigue la retícula a lo largo de las 8 actualizaciones.
Por esa razón, el modelo, tal como está implementado, todavía no dice nada sobre dominios proteicos. Por diseño es una prueba de concepto sobre una sola secuencia de nucleótidos, sin anotación de dominios ni conjunto de entrenamiento de proteínas; g nunca se lee y los dos símbolos de terminación nunca aparecen; m está fijo en 8; y la matriz de Dayhoff aparece solo en una diapositiva. El proyecto no tiene evaluación, y el objetivo de validación de abril no llegó a la versión final de las diapositivas.
Las referencias de las diapositivas también tienen errores. La cita principal dice “Qiu, Y., Zhang, X. (2020)”, mientras que el artículo con ese DOI es de Xuan Xiao, Guang-Fu Xue, Biljana Stamatovic y Wang-Ren Qiu [1]. La segunda referencia da “Q. Rev. Biol. 21:745” para un DOI que lleva a Mathematics of Computation 21(100):745 [2]. Ninguna de las cinco imágenes de las diapositivas indica su fuente, así que la Figura 1 vuelve a dibujar las reglas a partir del texto de las diapositivas.
La diapositiva titulada Futuro enumera tres puntos. El primero dice, en presente, que la implementación usa dominios proteicos de una base de datos establecida para generar estructuras reales; el repositorio no contiene esos datos, así que lo leo como un paso planeado. El segundo propone usar MDAT con estructuras reales y con las generadas para producir valores que midan qué tan similar es su evolución [4]. El tercero es una pregunta abierta: ¿qué tan factibles son los métodos de generación aleatoria para la búsqueda de estructuras?
Cómo reproducirlo
Estos comandos se ejecutan desde un clon nuevo. Se verificaron en la re-ejecución de octubre de 2026 con Python 3.9.6, numpy 2.0.2, nbconvert 7.17.2 e ipykernel 6.31.0.
git clone https://github.com/JCastrejonE/proyecto-computacion-genomica.git
cd proyecto-computacion-genomica
python3 -m venv .venv
.venv/bin/pip install numpy==2.0.2 nbconvert==7.17.2 ipykernel==6.31.0
cd src
../.venv/bin/jupyter nbconvert --to notebook --execute --output CA.rerun.ipynb CA.ipynb
La primera celda de CA.rerun.ipynb imprime los mismos 32 valores que el notebook guardado en el repositorio. La tercera celda imprime bases distintas en cada ejecución, porque el notebook no fija ninguna semilla.
Las verificaciones con semilla necesitan un script corto, que el repositorio no incluye. Guárdalo como check.py en la raíz del repositorio y ejecútalo desde src:
import json
import numpy as np

nb = json.load(open("CA.ipynb"))
exec("".join(nb["cells"][0]["source"]))  # builds and prints F2B and B2F
exec("".join(nb["cells"][1]["source"]))  # defines AutomataCelular

class Synchronous(AutomataCelular):
    # Every cell reads the previous step. Rules A and D leave the cell as it is.
    def actualizar_estado(self, t):
        prev = self.CA.copy()
        for j in range(1, 2 * self.m):
            if prev[j] == "∅" and prev[j-1] != "∅" and prev[j+1] == "∅":
                self.CA[j] = self.seleccion_ruleta(self.F2B[prev[j-1]])
            elif prev[j] == "∅" and prev[j-1] == "∅" and prev[j+1] != "∅":
                self.CA[j] = self.seleccion_ruleta(self.B2F[prev[j+1]])

for cls in (AutomataCelular, Synchronous):
    np.random.seed(1)
    ca = cls(m=8, g=4, dominio_ancestral="A", F2B=F2B, B2F=B2F)
    ca.ejecutar()
    print(ca.CA)

np.random.seed(12345)
full = 0
for _ in range(10000):
    ca = AutomataCelular(m=8, g=4, dominio_ancestral="A", F2B=F2B, B2F=B2F)
    ca.actualizar_estado(0)
    full += all(c != "∅" for c in ca.CA[9:16])
print(full)
../.venv/bin/python ../check.py
Imprime las matrices, las filas de los dos paneles de la Figura 4 (filas finales ∅GATTAATAATTGCAA∅ y ∅ATTATATAATGTAAG∅) y, como última línea, 10000.
Referencias
- Xiao, X., Xue, G.-F., Stamatovic, B., y Qiu, W.-R. (2020). Using Cellular Automata to Simulate Domain Evolution in Proteins. Frontiers in Genetics 11:515. doi:10.3389/fgene.2020.00515. Las diapositivas citan este artículo como “Qiu, Y., Zhang, X. (2020)”.
- Schwartz, J. T., von Neumann, J., y Burks, A. W. (1967). Theory of Self-Reproducing Automata. Mathematics of Computation 21(100):745. doi:10.2307/2005041. Las diapositivas indican como revista “Q. Rev. Biol. 21:745”.
- Dayhoff, M. O., Schwartz, R. M., y Orcutt, B. C. (1978). A model of evolutionary change in proteins. En Atlas of Protein Sequence and Structure, 5(3). Natl. Biomed. Res. Found., Washington DC, pp. 345–352, según la cita de las diapositivas.
- Kemena, C., Bitard-Feildel, T., y Bornberg-Bauer, E. (2015). El artículo que presenta MDAT. BMC Bioinformatics 16:19. doi:10.1186/s12859-014-0442-7. Las diapositivas mencionan MDAT sin cita.
- Castrejón, J. C. (2023). Diapositivas: presentacion/main.tex y presentacion/output.pdf.
- Castrejón, J. C. (2023). Notebook y archivo de entrada: src/CA.ipynb y src/protein.fasta.